30 секунд
В препринте HyCoSeq предложена модель представлений геномных последовательностей, соединяющая гиперболическое локальное кодирование и двунаправленную LSTM-сеть. Авторы сообщают о преимуществах над гиперболическими базовыми моделями и сопоставимых результатах с более крупными предобученными ДНК-моделями без масштабного геномного предобучения. Эти выводы относятся к проведённым исследовательским сравнениям: сама аннотация не даёт оснований объявлять HyCoSeq лучшей моделью для любой задачи или клинического применения.
Подробнее
Чэньхао Цзэн, Чжибинь Пу и Шуфэй Гэ представили HyCoSeq — способ строить контекстные представления геномных последовательностей. В аннотации препринта авторы указывают на ограничение существующих гиперболических моделей: локальное кодирование не сопровождается прямым объединением полных представлений в остаточных путях.
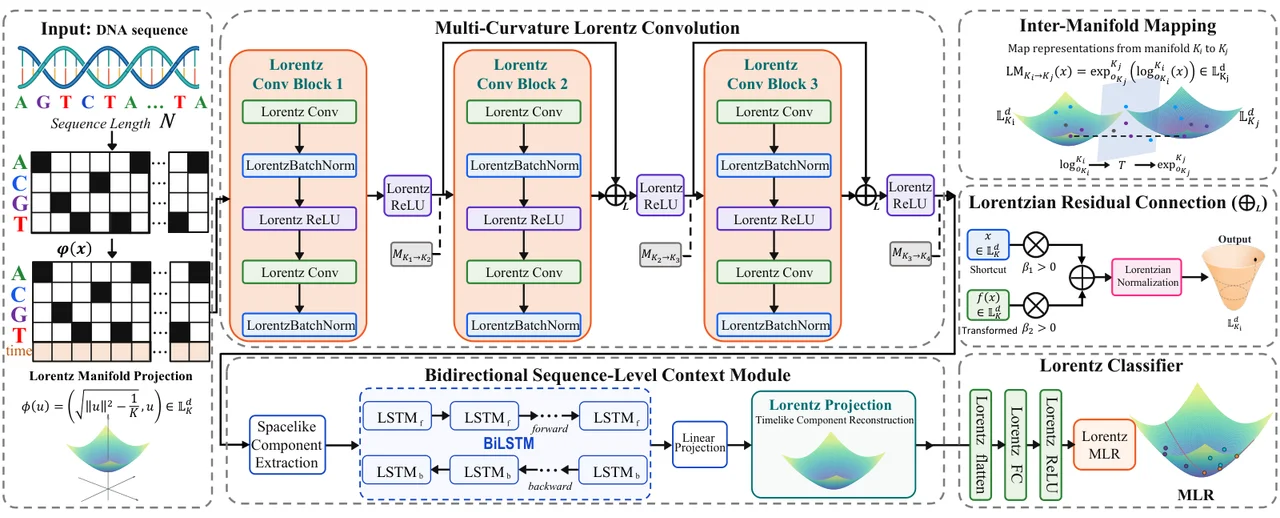
HyCoSeq добавляет взвешенную лоренцеву остаточную агрегацию в кодирование с несколькими кривизнами. Следующий компонент — двунаправленная LSTM-сеть: она собирает информацию с обеих сторон последовательности и связывает локальные представления на уровне всей последовательности. Так в архитектуре разделены локальная геометрия и более широкий контекст.
По сообщению авторов, в экспериментах на разных геномных задачах метод превзошёл гиперболические базовые модели и показал конкурентные результаты рядом с существенно более крупными предобученными ДНК-моделями. Крупномасштабное геномное предобучение для этого не использовалось. Сохранённый источник — аннотация первой версии от 15 сентября 2026 года: точные метрики, выборки и детали протокола здесь не раскрываются.
Что это значит
Сопоставимость начинается с условий обучения
Заявление о HyCoSeq объединяет два разных сравнения: преимущество над гиперболическими базовыми моделями и конкурентность относительно более крупных предобученных ДНК-моделей. Отсутствие масштабного геномного предобучения описывает условие получения результата, а не универсальную замену всех способов обучения.
Архитектурный вклад тоже конкретен: локальные представления объединяются геометрически согласованным способом, затем получают контекст с двух направлений. Для переноса вывода на другую задачу нужны её собственные данные и протокол оценки; в одной аннотации таких оснований нет.